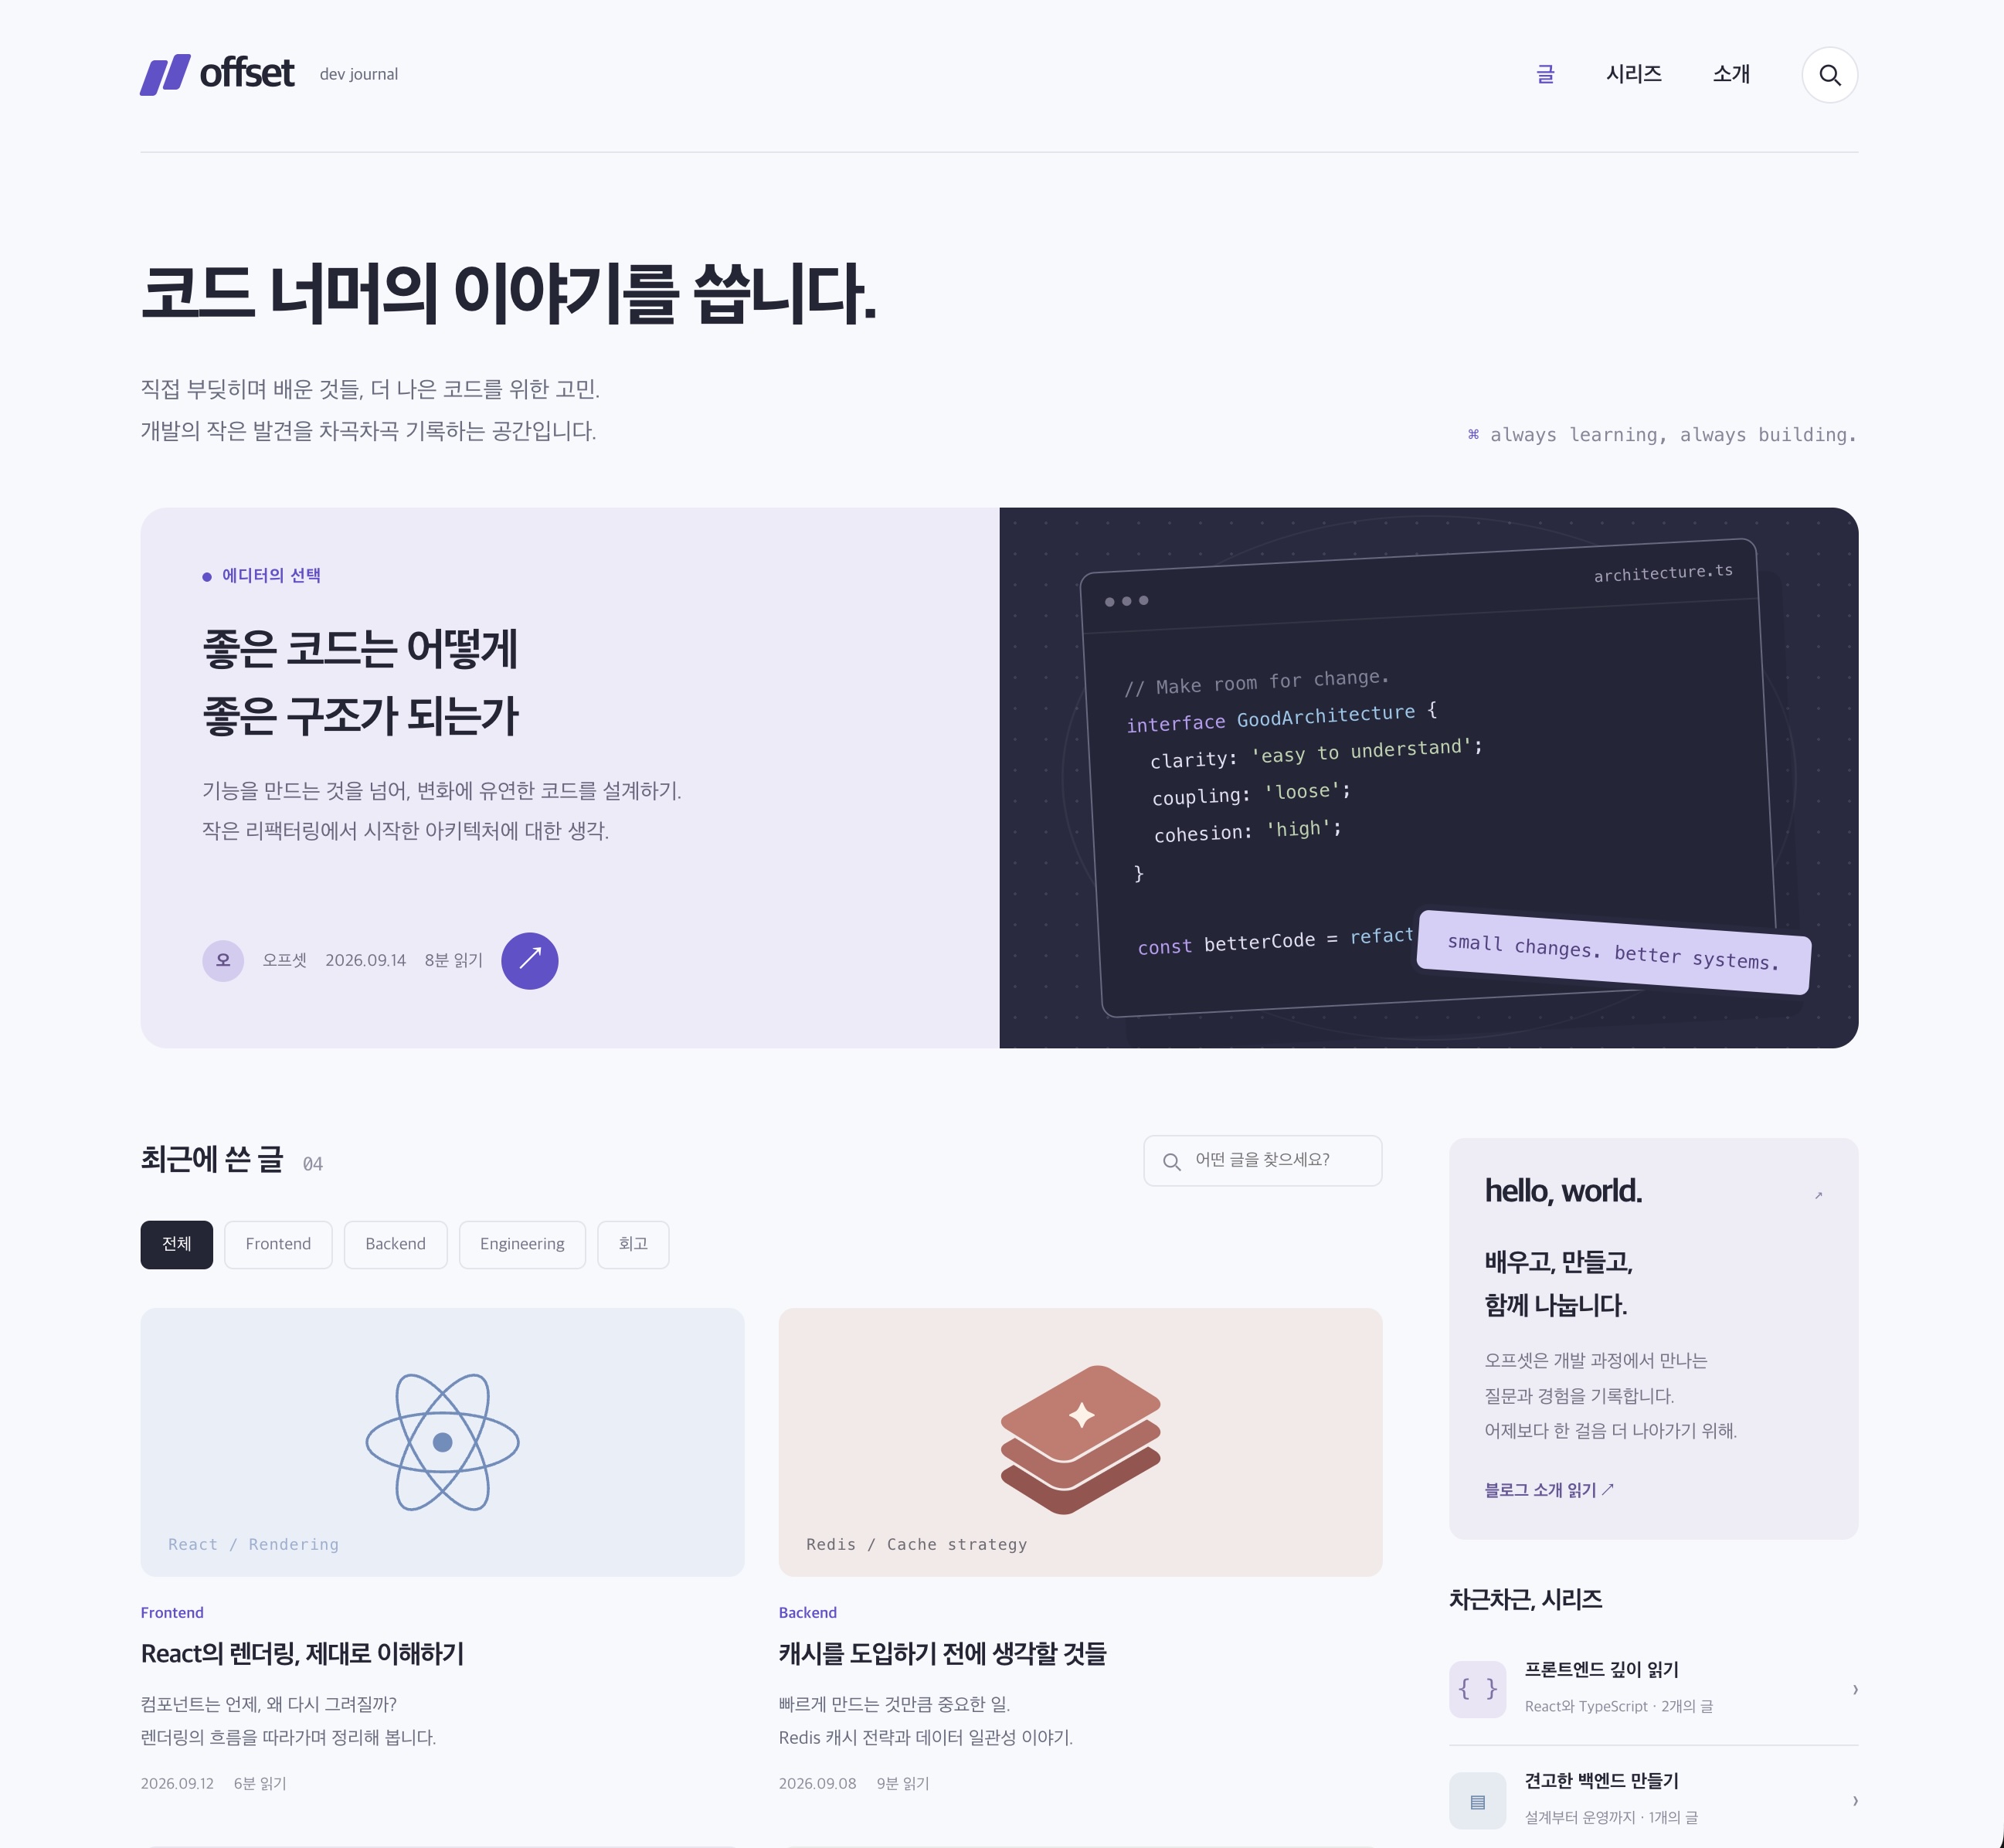
AI한테 화면을 맡기면 결과가 늘 비슷하다.
- 모서리가 둥근 카드
- 모든 요소에 들어간 그림자
- 이유 없이 넓은 여백
- 스크롤하면 아래에서 떠오르는 애니메이션
위 화면은 GPT한테 개발 블로그 랜딩 페이지를 HTML로 만들게 해서 캡처한 것이다. 여담이지만 모델마다 기본값의 결도 다르다. 내가 써 본 느낌으로는 Claude한테 페이지를 맡기면 차분한 쪽으로 간다. 크림색이나 베이지색을 자주 쓰고, 요소를 늘리기보다 문구와 여백으로 페이지 전체의 분위기를 만든다. GPT는 반대다. 보라색이나 라벤더색이 유독 자주 나오고, 카드와 버튼, 아이콘으로 기능을 하나하나 드러낸다. 요소가 많고 어디서 많이 본 템플릿 같다.
그래서 나는 거의 매번 "좀 더 예쁘고 깔끔하게 만들어줘"라고 덧붙인다. 매번 덧붙인다는 건, 그 한 줄이 한 번도 제대로 통한 적이 없다는 뜻이다.
AI를 잘 쓰는 방법으로는 보통 두 가지 이야기가 나온다. 하나는 프롬프트를 잘 쓰라는 것이다. 다른 하나는 스킬, 서브에이전트, 커맨드 같은 기능을 제대로 알고 효율적으로 쓰라는 것이다. 직접 도구를 만들어 보니 둘 다 반만 맞았다.
"예쁘게"와 "자연스럽게"는 기준이 아니다
디자인보다 먼저 부딪힌 건 글이었다. AI가 쓴 한국어 초안은 읽자마자 티가 난다. "~에 있어", "결론적으로", "이를 통해"가 줄줄이 나오고, 문장 길이가 전부 비슷하다. 그래서 초안을 내 글에 맞는 결로 다듬어 주는 스킬을 만들었다. 이름은 gyeol(글결)이다.
처음 떠올린 방법은 "자연스럽게 다듬어줘"를 더 공들인 프롬프트로 바꾸는 것이었다. 그런데 자연스럽다는 게 뭔지를 내가 말할 수 없었다. 말할 수 없는 기준은 AI도 지킬 수 없다.
그래서 기준을 글로 설명하는 대신 수치로 쟀다. 내가 닮고 싶은 글 세 편을 골라서, 같은 항목을 AI 초안과 나란히 측정했다.
| 문장 길이 변동계수 | 한자어 명사화 | 결산 관용구 | |
|---|---|---|---|
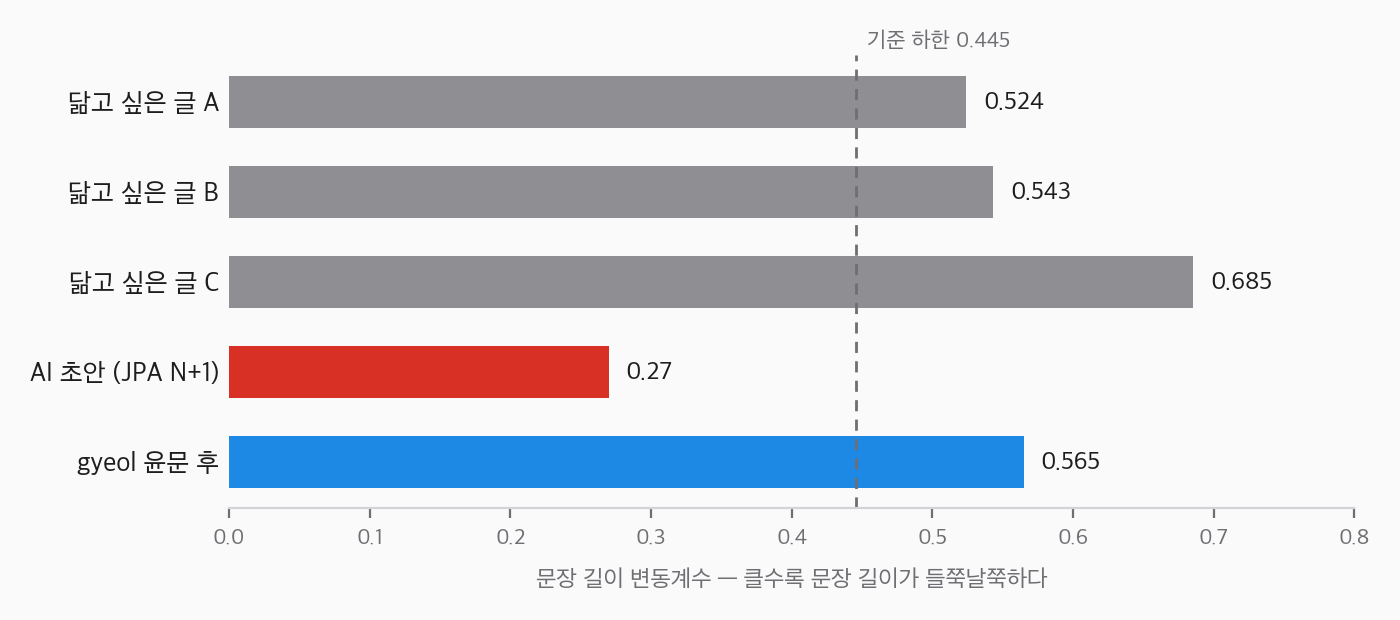
| 닮고 싶은 글 3편 | 0.52 ~ 0.69 | 0.007 ~ 0.016 | 0 ~ 2 |
| AI 초안 (JPA N+1 글) | 0.27 | 0.031 | 2 |
차이가 제일 큰 건 문장 길이였다. 사람 글은 5자짜리 문장 뒤에 170자짜리 문장이 오기도 한다. AI 초안은 23문장 중 20개가 30~70자 사이에 몰려 있었다. "자연스럽게"라는 말 뒤에 숨어 있던 기준 하나가 이렇게 숫자로 나왔다.
기준이 생기니 반대 방향도 판단됐다. 당근 기술블로그 글을 넣어 봤더니 모든 항목이 범위 안이었고, 손댈 필요가 없다고 나왔다. 좋은 윤문 도구는 많이 고치는 도구가 아니라 고치지 않아도 되는 글을 알아보는 도구였다.
AI가 AI를 채점하면 늘 통과한다
기준을 정했으면 누가 판정할지도 정해야 한다. AI한테 다듬게 하고 "잘 다듬어졌는지"까지 물으면 대답은 늘 "잘 다듬어졌다"다.
그래서 판정은 파이썬 스크립트가 하게 했다. AI는 윤문만 하고, 결과가 기준 안에 들어왔는지는 코드가 본다. 실제로 돌렸을 때 첫 윤문은 이렇게 끝났다.
[gate] 중단 (exit 2) / 변경률 53.0%
  - change_rate: 0.5305 (임계 0.5) — 의미가 드리프트했을 가능성이 높다
AI가 목록을 산문으로 풀고 원문을 4분의 1쯤 덜어내 버린 탓이다. 원문 구조를 살려 다시 쓰게 하자 30% 선까지 내려왔다. AI가 스스로 채점했다면 1차본이 그대로 나갔을 것이다.
30% 선까지 내려온 윤문본에서 첫 문장과 마지막 문단은 이렇게 바뀌었다.
윤문 전 백엔드 개발에 있어 성능 최적화는 매우 중요한 요소입니다. 특히 JPA를 사용하는 프로젝트에서는 N+1 문제가 빈번하게 발생하며, 이는 애플리케이션의 응답 속도에 치명적인 영향을 미칠 수 있습니다.
윤문 후 백엔드에서 성능 최적화는 중요한데, 특히 JPA를 쓰는 프로젝트에서는 N+1 문제가 자주 생기고 애플리케이션 응답 속도에 치명적인 영향을 줍니다.
윤문 전 결론적으로 N+1 문제는 JPA를 사용하는 개발자라면 반드시 이해하고 있어야 하는 핵심 개념이라고 할 수 있습니다. 이를 통해 보다 효율적인 애플리케이션을 구축할 수 있을 것입니다. 앞으로도 지속적인 학습을 통해 성장해 나가시길 바랍니다.
윤문 후 N+1 문제는 JPA를 쓰는 개발자라면 반드시 이해하고 있어야 하는 개념입니다.
| 윤문 전 | 윤문 후 | |
|---|---|---|
| 문장 길이 변동계수 | 0.27 | 0.565 |
| 한자어 명사화 | 0.031 | 0.010 |
| 결산 관용구 | 2 | 0 |
| 핵심 명사 보존 | — | 30 / 30 |
문장 길이 편차가 닮고 싶은 글들의 범위로 들어왔고, 핵심 명사 30개는 하나도 빠지지 않았다. 빠진 건 "결론적으로"로 시작하는 결산과 "성장해 나가시길 바랍니다" 같은 인사말이었다.
코드가 판정하면 사람 눈에 잘 안 띄는 실패도 잡힌다. 일부러 초안에서 "~더라고요", "삽질", "솔직히" 같은 표현만 걷어낸 테스트 케이스를 만들어 봤다. 글자는 8%밖에 안 바뀌어서 변경률로는 통과였다. 하지만 이런 사람 냄새 나는 표현이 원래의 14%만 남아 있었고, 게이트가 여기서 걸었다. 의미는 그대로인데 사람만 빠진 글이 AI 윤문의 가장 흔한 실패다.
이 구조는 하드닝 글에서 보안 리뷰에 썼던 것과 같다. 발견하는 AI와 판정하는 쪽을 나눈다. 분야가 달라도 AI 결과를 믿으려면 판정을 AI 밖으로 빼야 했다.
그렇다고 코드의 판정이 늘 맞는 건 아니다. 이 글도 gyeol에 넣어 봤다. 변경률 0%, 사람 냄새 나는 표현 유지율 100%로 고칠 곳이 없다고 나왔는데, 게이트는 경고를 띄웠다. 결산 관용구가 기준보다 많다는 것이었다. 세어 보니 앞에서 AI 글의 예로 따옴표 안에 적은 "결론적으로"와 "이를 통해"였다. 스크립트는 단어를 쓴 것과 단어를 언급한 것을 구분하지 못한다. 수치를 맞추려고 인용을 고치면 이 글이 무엇을 비판하는지가 사라지니, 이 경고는 확인만 하고 넘겼다. 판정을 코드에 맡겨도 그 판정을 읽고 어떻게 할지 정하는 건 여전히 내 몫이었다.
쓰기 전 규칙과 쓴 뒤 검사는 다르다
기능을 효율적으로 쓰라는 이야기도 직접 부딪혀 보니 구체적이었다. 처음엔 규칙을 전부 미리 넣어 두고 쓰면 윤문이 필요 없을 거라고 봤다. 반은 틀렸다.
"~에 있어서를 쓰지 마라"는 문장을 쓰는 순간에 지킬 수 있다. "~를 통해를 한 문단에 세 번 이상 쓰지 마라"는 지킬 수 없다. 문단이 끝나기 전에는 이미 몇 번 썼는지 알 수 없기 때문이다.
그래서 규칙을 원본 하나에 모아 두고 둘로 나눠 빌드했다. 쓰기 전에 주는 규칙 20개, 쓴 뒤에 검사하는 규칙 36개다. 쓰기 전 규칙이 짧아야 매번 컨텍스트에 얹혀도 부담이 없고, 초안이 깨끗하게 나올수록 뒤에서 돌아가는 AI 호출 수도 줄어든다. 효율은 기능을 많이 쓰는 데서 나오지 않았다. 규칙을 지킬 수 있는 시점에 두는 데서 나왔다.
내 입맛에 맞는 AI
이렇게 만든 것들을 skill-kit이라는 저장소 하나로 묶었다.
| 플러그인 | 하는 일 |
|---|---|
| gyeol | AI 초안을 내가 고른 글들의 글투로 맞춘다 |
| hardening | 레드팀이 찾고, 검증을 통과한 것만 블루팀이 고친다 |
| game-reference | 게임 레퍼런스를 미국 매출 순위와 리텐션으로 찾는다 |
| lecture-summary | PDF 강의자료를 한글 요약 노트로 정리한다 |
넷의 공통점은 기능이 아니다. 내가 원하는 결과가 뭔지를 먼저 적어 두었다는 것이다. 어떤 글투를 원하는지, 어떤 보안 발견을 믿을지, 어떤 게임을 레퍼런스로 칠지, 요약 노트가 어떤 모양이어야 하는지.
한계도 분명하다. 1인칭 문장도 경험 이야기도 없는 AI 초안을 넣으면 gyeol은 목소리를 만들어 주지 못한다. 없는 경험을 지어내면 그건 윤문이 아니라 거짓말이다. 문장 길이와 관용구는 고쳐도 목소리는 쓰는 사람이 채워야 한다.
AI의 기본값은 평균이다
AI 글쓰기의 특징을 정리한 Wikipedia 문서 Signs of AI writing에 이런 문장이 있다.
LLM은 다음에 올 말을 통계로 추측한다. 그래서 결과는 가장 많은 경우에 두루 들어맞는, 통계적으로 가장 그럴듯한 쪽으로 기운다.
처음의 둥근 카드가 딱 그렇다. 틀린 디자인은 아니다. 어느 서비스에 붙여도 크게 어긋나지 않아서 가장 많이 쓰였고, 가장 많이 쓰였으니 AI가 제일 먼저 꺼낸다. 문단을 "결론적으로"로 여는 글도 같은 이유로 나온다. 둘 다 안전하고 리스크가 없는 답이다. 대신 신박하지는 않다.
AI는 이 평균에서 스스로 벗어나지 않는다. 평균은 틀릴 위험이 가장 적은 자리라서, 거기서 벗어날 이유가 AI에게는 없다. "더 예쁘게"라고 하면 평균 안에서 조금 더 다듬은 답이 돌아올 뿐이다. 어느 방향으로, 얼마나 벗어날지는 쓰는 사람이 정해야 한다. gyeol에서 닮고 싶은 글 세 편을 직접 고른 게 그 일이었다. 평균을 뚫고 나온 결과물을 만들지는 AI가 아니라 사용자에게 달려 있다.
고민이 코드에서 설계로 옮겨갔다
gyeol의 파이썬 코드는 테스트까지 1,118줄이다. 한 줄도 내가 직접 치지 않았다. 계량 스크립트, 게이트, 규칙 빌드, 검증기 모두 AI가 짰고, 테스트를 돌려 가며 고치는 것도 AI가 했다.
대신 내가 붙잡고 있던 건 이런 질문들이었다.
- 이 도구가 다룰 글은 무엇이고, 어디까지 무겁게 만들 것인가
- 어떤 글을 닮고 싶은가. 기준으로 삼을 글 세 편을 고르는 일
- 윤문이 잘됐는지를 누가 판정하는가
- 쓰기 전에 줄 규칙과 쓴 뒤에 볼 규칙을 어떻게 나누는가
- 누구에게 공개하고, 무슨 이름으로 부를 것인가
어느 것도 코드를 어떻게 짤지에 대한 질문이 아니다. 무엇을 만들고, 무엇을 지키고, 무엇을 버릴지에 대한 질문이다. 이걸 정하고 나면 코드는 빨리 나왔다. 이걸 안 정한 채로 코드부터 시켰다면, AI는 아마 가장 평균적인 윤문기를 만들었을 것이다.
코드를 어떻게 짤지 고민하는 시간은 확실히 줄었다. 줄어든 만큼이 서비스를 어떻게 설계할지로 옮겨 갔다. 앞에서 말한 평균을 뚫는 방향도 결국 설계 단계에서 정해진다. 코드는 그 결정을 따라갈 뿐이다.
다음은 디자인이다
디자인은 아직 방향을 정하지 않은 상태다. 방향을 정해 주지 않았으니 AI는 매번 평균으로 돌아간다.
다음으로 만들 건 디자인 스킬이다. 순서는 gyeol과 같게 가려고 한다. 먼저 내가 좋다고 느끼는 화면을 모으고, 그 화면들에서 뭘 셀 수 있는지 찾는다. 그림자가 몇 군데 들어가는지, 모서리 둥글기가 몇 가지인지 같은 것들이다. 셀 수 있으면 "예쁘게"라는 말 없이도 AI에게 기준을 건넬 수 있고, 결과가 그 기준 안에 들어왔는지도 AI가 아닌 쪽이 확인할 수 있다.
ECC에 기여했던 글에서는 좋은 스킬이 AI가 틀리는 걸 막는 가드레일이라고 썼다. 이번에 만들면서 하나를 더 알게 됐다. 틀리는 걸 막으려면 먼저 뭐가 맞는지를 내가 정해 둬야 한다.
AI를 잘 쓴다는 건 프롬프트를 잘 쓰는 것도, 기능을 많이 아는 것도 아니었다. AI는 가만두면 평균을 낸다. 거기서 어디로 벗어날지는 내가 정하고, 그걸 AI가 건너뛸 수 없는 곳에 적어 두는 일에 가까웠다. 디자인에서도 그게 통할지는 만들어 봐야 안다.